如何让知识库变为你的数字资产:构建一个 Agent 能直接读的本地库
Table of contents
前几天我跟 Agent 说,把上周的投资复盘整理一下,顺便看看跟去年同期比有什么变化。它自己找到了当月的记录文件,翻了前两年同期的复盘,读了我放数字的那个目录,写完之后落回对应的位置,全程我没告诉它任何路径。
这件事在我用云笔记的那三年里是不敢想象的。
不是因为模型变强了,是因为我的东西从别人的数据库里搬到了我自己的文件系统里。 知识管理这件事在 AI 来了之后,真正重要的问题只剩一个:你的 Agent 能不能读到你所有的东西。 双链、卡片盒、第二大脑这些讨论,在这个问题面前基本失效了。
这篇讲我是怎么搭的本地知识库,包括几个关键点:存量怎么搬、目录怎么定、如何长期维护。而不讲 Obsidian 的基础操作,因为本质上ob也没什么操作可言,我只把它当成一个本地知识库的可编辑器。
1️⃣ 本地知识库是最 AI Native 的方式
云笔记过去的护城河是同步、协作、跨端、API,这几样在 AI 面前的处境非常尴尬。
Agent 的原生接口就是读文件、搜文件、写文件。给它一个本地目录,它 grep 一下就知道你有什么,读几个 README 就知道你怎么组织目录结构的,但如果你给它一个云笔记账号,它得先过鉴权,再调 API,一次只能拿一页,附件还得单独取,而且多数时候它根本没有这个通道(很多云笔记厂商到现在都还没支持cli\mcp)。
我的知识库现在有几千万字,超过300MB,算是很大的一个知识库。但Agent 依旧不需要任何插件、不需要 MCP、不需要搭太多的脚手架和记忆,直接就能读、并且读懂我的目录结构,准确定位到所需要的文件,这种Agent能快速定位 + 读取对应信息装载到上下文的知识库才算是AI时代的数字资产。
所以本地优先这件事,是这个时代知识管理的默认形式,也是公认的最AI Native的方式。
2️⃣ 第一步:把存量知识库搬出来
我之前把语雀里过去三年的全部文件全导出来了,花的功夫比我预想的多不少。
这种云平台其实并不想让用户轻易迁出文件,所以导出的格式都是语雀专有的格式,需要编码对格式进行转换才能拿到md文件,我踩过的几个坑: 1、文件名后面挂一串 hash,得批量清理。 2、附件路径全是相对引用,搬完之后图片大面积失效,要重定向。 3、中文文件名在不同系统下的编码问题,偶发但很烦。
这些活我基本是让 Agent 批量干的,让写个脚本批量跑一遍比手动改快得多,不同的云上知识库对导出能力的支持程度不一样,但导出这个动作是非常有必要的。
迁移是一次性成本,留在云上是持续成本 。
3️⃣ 第二步:定目录结构
如果你有导出的存量 :它通常自带一套结构,也就是你在云上的知识库对应的结构,先沿用,别一上来重构,用一段时间发现哪里不顺再改,比凭空设计会更加准确。
如果完全从零开始 :按你预想的层级新建就行。不用追求一次到位,目录是活的,并且可以慢慢修改。
如果你手上只有一堆散乱的 Markdown :这种最省事,直接让 Agent 读一遍,让它按内容给你归类出一套目录方案,你审一下再执行。它比你自己肉眼分类快,而且它归的类天然是它自己后面更容易定位到的类。
我的顶层现在是十个目录,用数字前缀排序:
| 目录 | 放什么 |
|---|---|
00-about-me/ | 个人画像:履历、经历、价值观 |
10-daily/ | 每日流水 + 周复盘 + 常驻计划 |
20-knowledge/ | 领域知识沉淀 |
30-outputs/ | 对外产出:推文、长文、技术博客、翻译 |
40-dashboards/ | 看板 |
50-work/ | 公司工作文档(不进 git) |
90-archive/ | 过期废弃,不删只归档 |
_private/ | 私密内容(不进 git) |
_meta/ | 库自身的设计说明与结构演进日志 |
_assets/ | 图片等二进制附件 |
加上数字前缀不是为了好看,是为了让排序稳定,也让我在Agent对话里能直接说放 30而不用打全名,下划线开头的几个排在最后,一眼能看出它们是特殊区域:私有数据、库自身说明、图片、gif等素材。
4️⃣ 第三步:每个目录的索引结构
Agent 进到一个目录,它看到的是一堆文件名。文件名能告诉它的信息非常有限,它不知道这里该放什么、不该放什么、命名有什么规矩、跟隔壁目录的边界在哪。
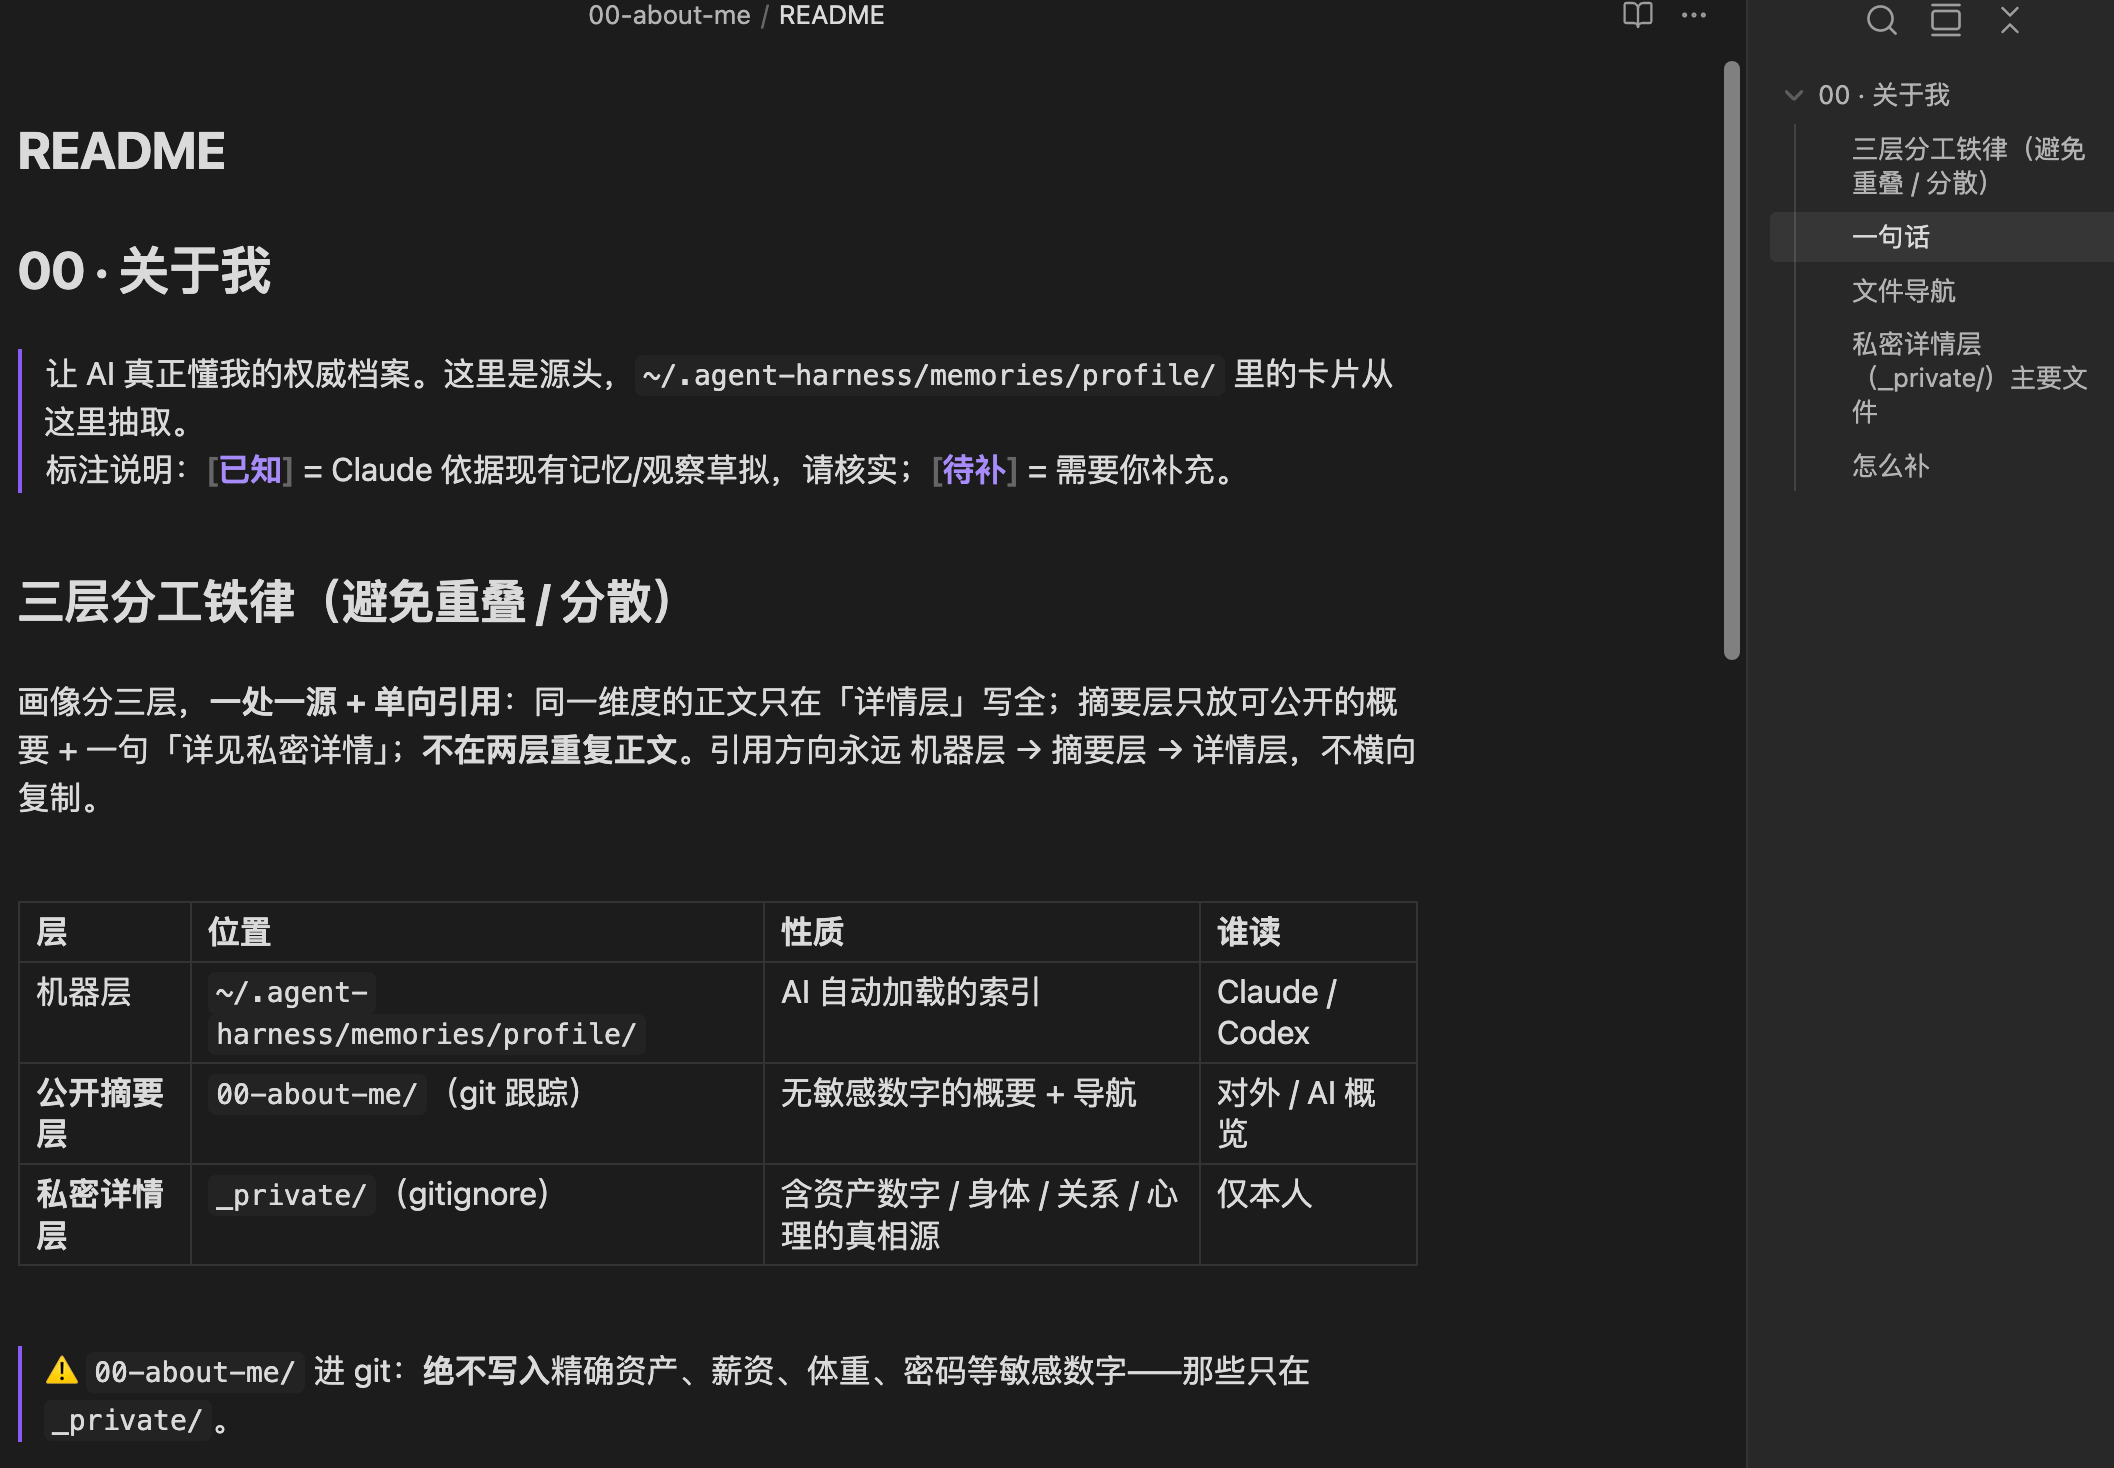
如何让Agent能够快速定位到它需要的文件呢?放一个 README 就解决了,我的 README 里基本就四件事: 1、这个目录放什么,一句话。 2、这个目录不放什么,以及不放的话该去哪找。 3、命名规则,特别是有日期或者编号的。 4、有没有特殊边界,比如这一层进不进 git。
比如这是我的其中一个目录的README文件
再往上加一层: 知识库根目录放一个专门给 Agent 看的导航文件 ,Claude Code 认 CLAUDE.md,别的工具认 AGENTS.md,内容可以一样,软链过去就行,这个文件写清楚整体知识库的大规则怎么找、怎么放,比如这是我的Agents.md内容。
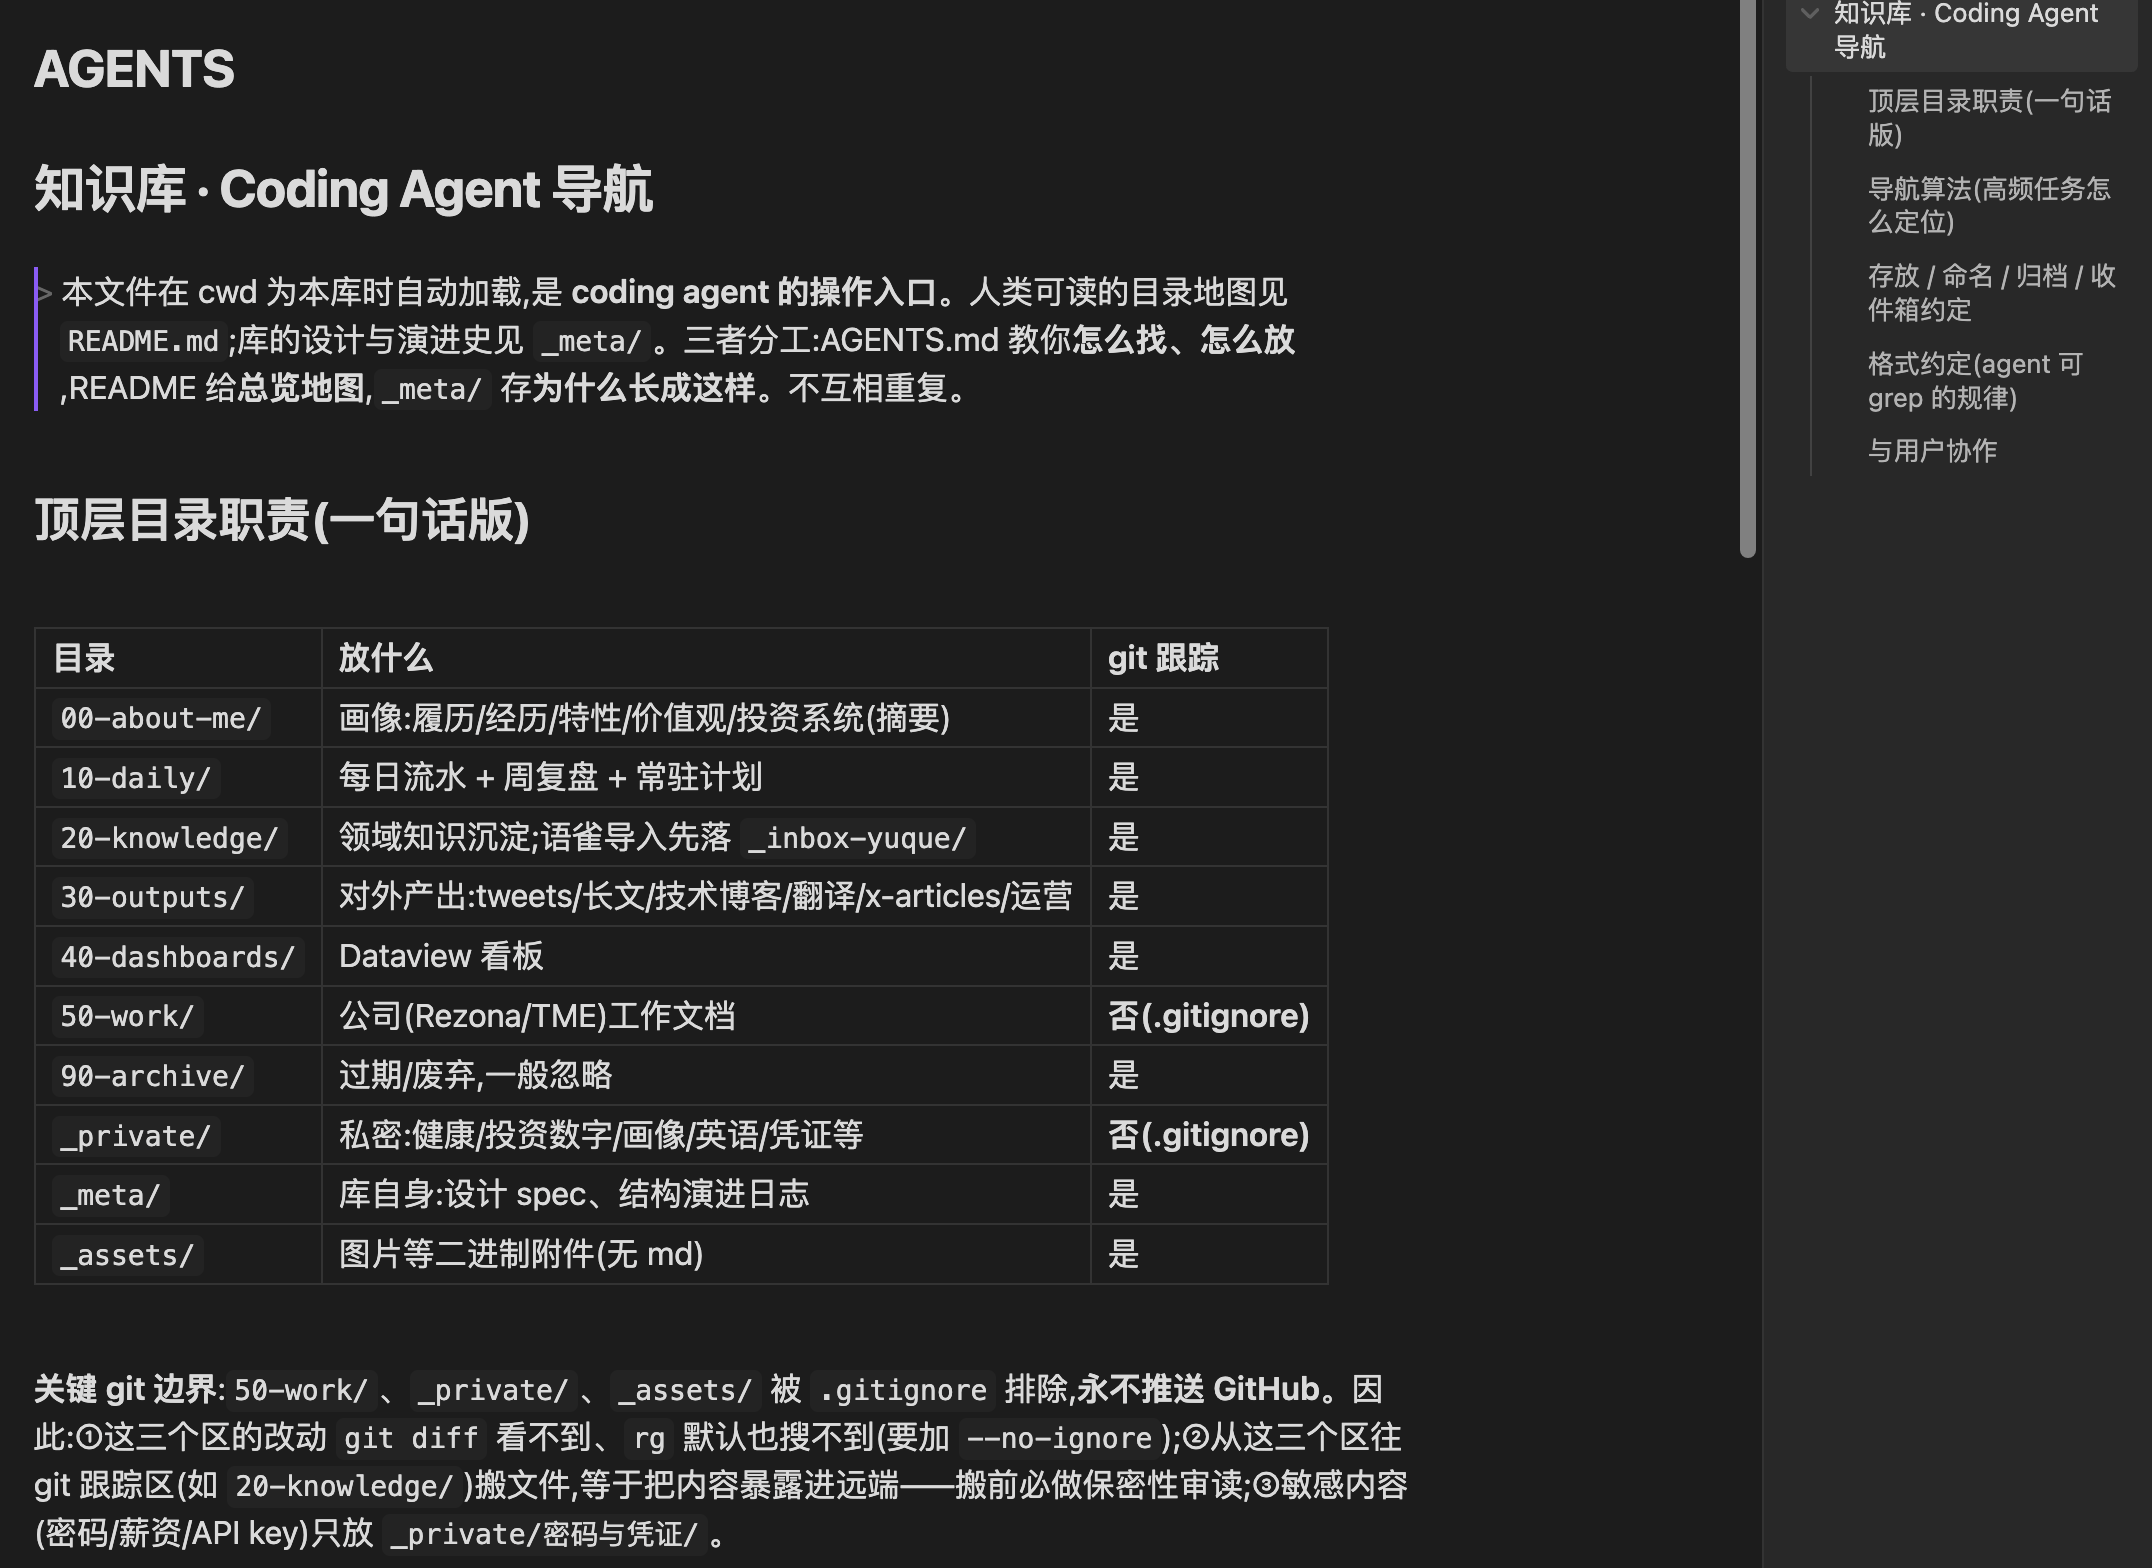
比如里面有这种条目:找某天的日记走哪个路径,2024 和 2025 是扁平结构、2026 起按月分目录,先按年份选对结构再进目录。
也有这种:拿财富数字的唯一事实源是哪个文件,其余文件里的数字都是引用,以那个为准。
这三层的分工我是这么划的:给 Agent 的导航文件教它 怎么找、怎么放 ,根目录 README 给人看 总览地图 ,_meta/ 存 为什么长成这样 。三者不互相重复,重复了以后就会互相矛盾,这种事实层面的矛盾非常容易误导 Agent。
而且这些说明文件是必须的,写这些说明文件花的时间,两周之内就靠少解释挣回来了,在AI的帮助下落地这些索引文件也花不了多少时间。
5️⃣ 维护心法:落盘
搭完之后最大的问题不是结构会不会变混乱,是知识库会不断长大,这个过程我们应该如何优雅的维护。
我一般这么丰富我的知识库:
- 平时跟 Agent 聊,聊到一个我觉得以后还会用到的结论,我就当场说一句落盘,指定放哪个目录。
- 固定一些知识库流水线:比如微信读书流水线,能够通过weread-skill去扒我的读书笔记,然后放到知识库对应目录下;比如他山之石流水线,能够转录youtube视频成文字稿,放在我的知识库对应目录下,他山之石的仓库链接 https://github.com/anneheartrecord/florilegium
这些动作的好处是它发生在结论刚产生的时候,等你想起来要整理,那个结论的上下文已经丢了一半,当场落盘落下来的是完整的判断加当时的处境。
什么值得落盘,我的标准是这几类: 1、我的偏好和习惯,尤其是纠正过 Agent 之后的那种(下次别这么干,要这么干)。 2、当时做某个决定的理由,特别是理由不在代码和 git 记录里的一些决定。 3、外部资源的入口,链接、文档、看板地址。 4、新学到的知识和笔记
什么不值得落:代码结构、修过的 bug、git 历史里查得到的东西,这些让它现场读就行,落下来只会过期,还有只对当次对话有效的临时结论,落了就是噪音。
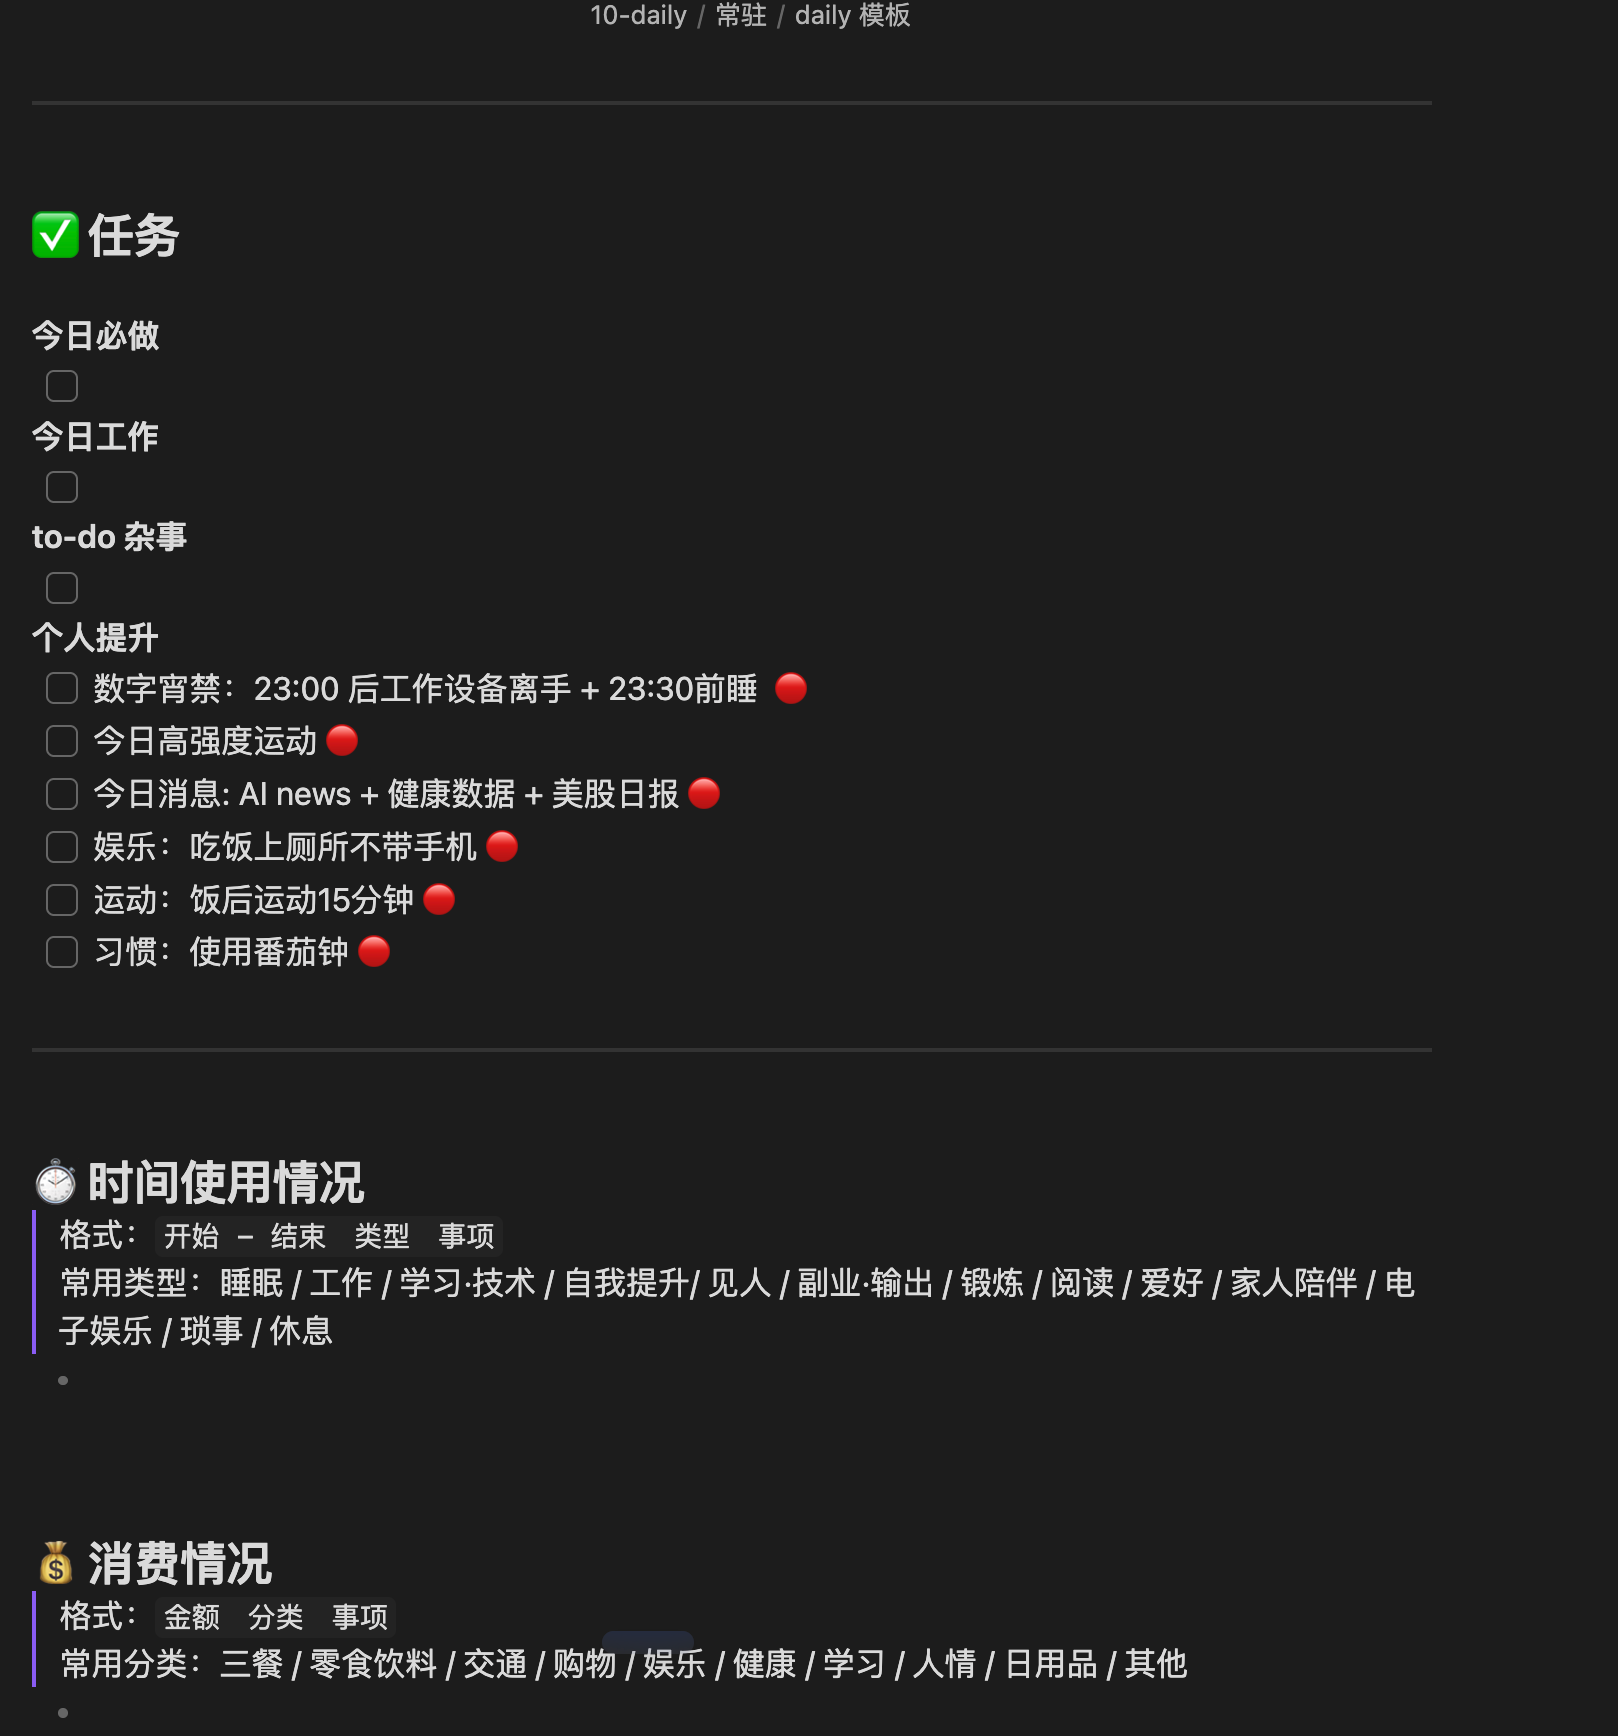
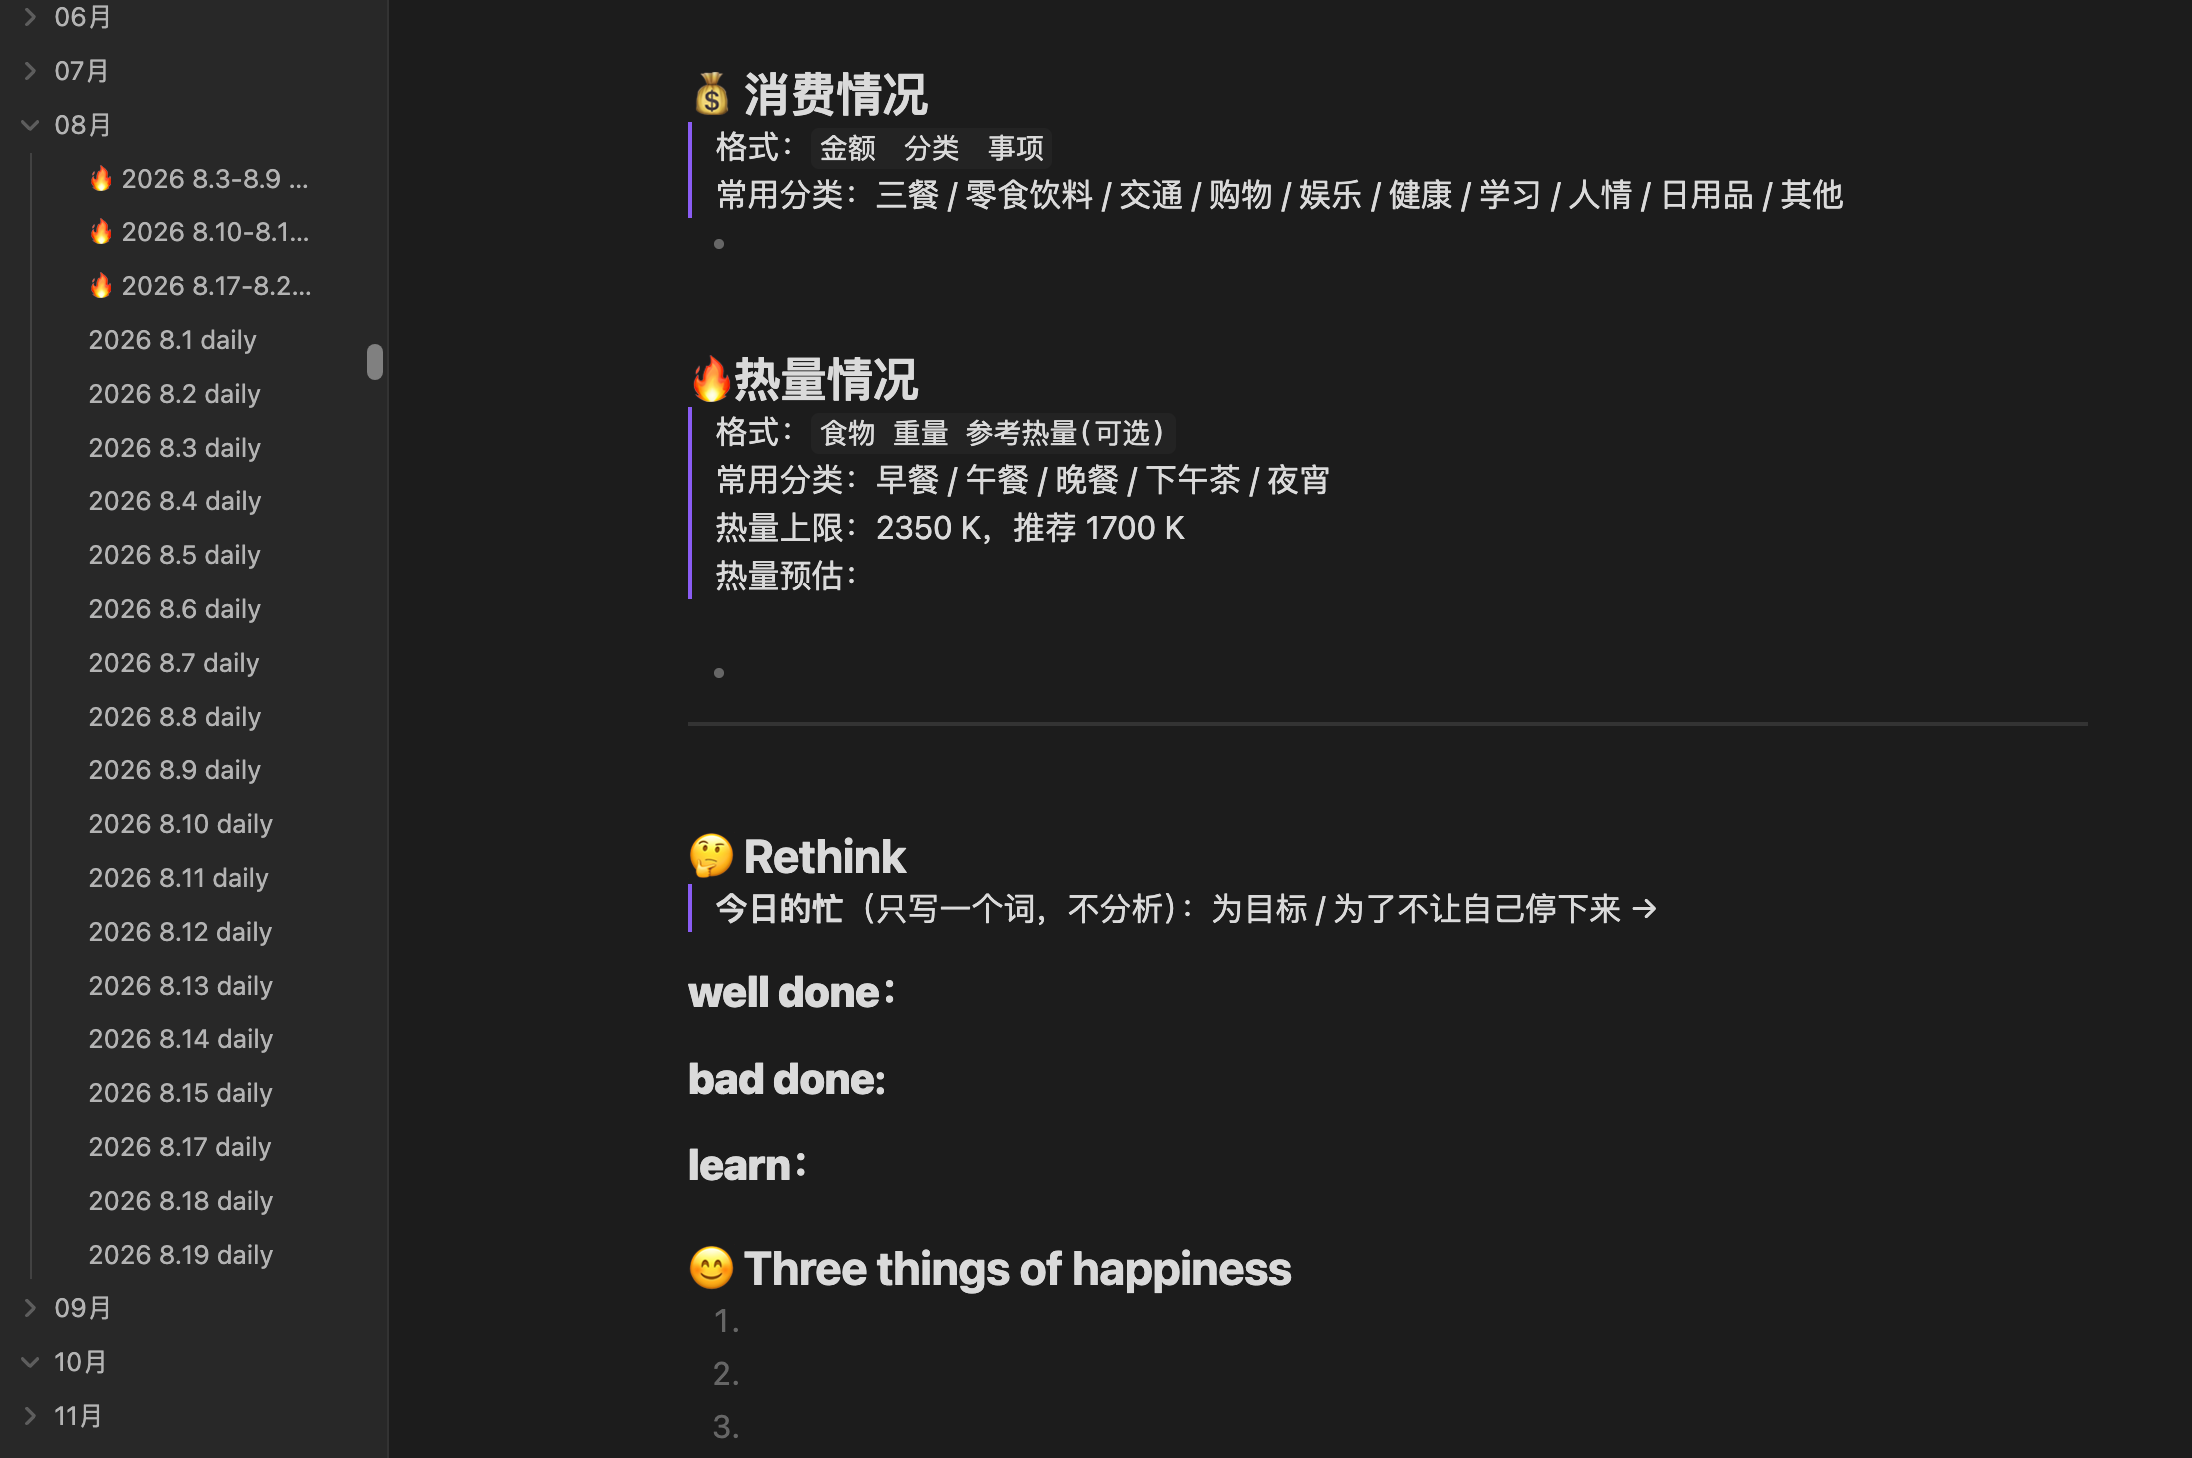
我现在的库99%的新增内容是这么攒起来的,不是坐下来写出来的,只有daily记录我会手写,像是每周的复盘都不再手写,而是AI读我的daily给我总结,下面是我的具体模板,基本每天都有在跟踪和记录。
6️⃣ 哪些东西永远不能进 git
我的知识库是会推 GitHub 的,用于做一个服务端的备份,虽然是Private仓库,但还是有几个区必须排除掉:公司工作文档、私密内容、二进制附件,全走 .gitignore。
这里有个不那么显然的坑,我提一下: 从排除区往被跟踪区搬文件,等于把内容暴露到远端。 我在给 Agent 的导航文件里专门写了一条,搬这个方向的文件之前必须做一次保密性审读。因为搬文件这个动作在 Agent 看来是纯技术操作,它不会自动意识到跨越了一条边界。
另外密码、API key 这类东西只放私密区里固定的一个位置,绝不内联进任何会被提交的配置文件,配置里只引用环境变量名。
7️⃣ 两个很好用的OB插件
我的OB社区插件只装了两个,都还开着,少装插件本身也是个我的一个习惯:插件越多,库的可移植性越差,而本地库最大的价值就是它是纯文本、换个工具也能读。
- Dataview:让随手记的东西自己长成看板
我在每天的日记里用行内字段记两个数(时间和开销),写法就是 [时长:: 1.5]、[金额:: 35],跟着当天那条流水一起写,不额外开表格。
Dataview 的作用是把这些散在各个日记里的字段查出来聚合。我的看板目录里就是一段查询,按月份汇总支出、笔数、分类占比,我一张表都不用维护。
它把记录的成本压到了最低 。以前我要么手动填表格,要么专门开个 App。现在记账这件事就是在写日记的时候多打七个字符,看板自己会更新, 现在所有的记账、时间记录、热量消耗、体重、每天做了什么、经历了什么、心情怎么样 ,都在我的知识库daily文档中, 我不再需要任何额外的记录APP,我的知识库就是大而全的记录APP 。
一个提醒:如果你的数据量大或者查询复杂,别让 Dataview 直接扫全库,性能会掉。我的做法是让脚本先把原始数据聚合成中间文件,Dataview 只查那个中间文件,快很多。
- Notebook Navigator:给人用的导航,和给 Agent 用的 README 正好互补
Obsidian 原生的文件树在库小的时候够用,到几百个文件、十个顶层目录之后就不行了,你得一层层点开找。
这个插件把侧边栏换成双栏的笔记本视图:左边文件夹,右边当前文件夹的笔记列表,带预览和封面图。找东西的体感接近 Bear 或者印象笔记,但底下还是你自己的 Markdown 文件夹,没有任何锁定。
我开的几个设置:双栏布局、自动定位到当前打开的文件、笔记列表显示预览、按修改时间倒序排。
8️⃣ 总结
写到这里基本的搭建、维护、使用方法基本都说完了,大体有几个要点
- 本地知识库一定是最AI Native的方式,如果你之前有云端知识库,花点时间把它迁移到本地一定是最高效的。
- 不一定非要选 Obsidian,在我眼里,Obsidian 本质上只是一个本地知识库的编辑器。本地知识库它本身就是一块存储,所有比较方便的编辑器都可以用,我用 Obsidian 主要是因为它比较火,而且插件确实也做得还不错。
- 有了知识库之后,一个很重要的任务就是把知识库变成 agent 易读的模式。你要建立足够多的索引,方便 agent 去找到你那一次对话到底需要加载什么文件,让它能快速找到。这决定了 agent 能不能足够懂你:你会发现,只要你记在知识库里,再给它一个便于寻找的目录结构,它就能很轻易地加载出对应的上下文。
- 你一定要长期去维护和丰富知识库,维护主要分两种:
(a) 第一种是你平常和 AI 的对话中产生的一些结论,可以落地沉淀下来,比如你的画像、对未来的规划等等。 (b) 第二种是你学到了一些东西,又不想手动整理,就可以通过一些外部的Skill或者引入到知识库中,比如微信读书流水线,能够通过weread-skill去扒我的读书笔记,然后放到知识库对应目录下;比如他山之石流水线,能够转录youtube视频成文字稿,放在我的知识库对应目录下,他山之石的仓库链接 https://github.com/anneheartrecord/florilegium。